Le 20 octobre, les détails de deux failles dans PHP ont fuité sur Internet avant que le correctif soit prêt. CVE-2026-109618 et CVE-2026-109619, surnommées « PHP2Shell » : exécution de code à distance, notées 9,2 sur 10, toutes les versions depuis PHP 5.4. Le correctif était annoncé pour le lendemain, 21 octobre, 16 h, heure belge.
Ce n'est pas une faille dans WordPress ou dans un plugin mal codé. C'est le moteur lui-même. Et le point d'entrée se situe là où PHP lit le contenu d'un formulaire envoyé, avant que le code du site ne s'exécute. La qualité du code de mes clients n'y changeait donc rien.
Je gère un serveur qui héberge une petite dizaine de sites et d'applications web, la plupart pour de petites structures, plus quelques machines ailleurs. Voici comment s'est passée cette journée, y compris ce que j'ai mal fait.
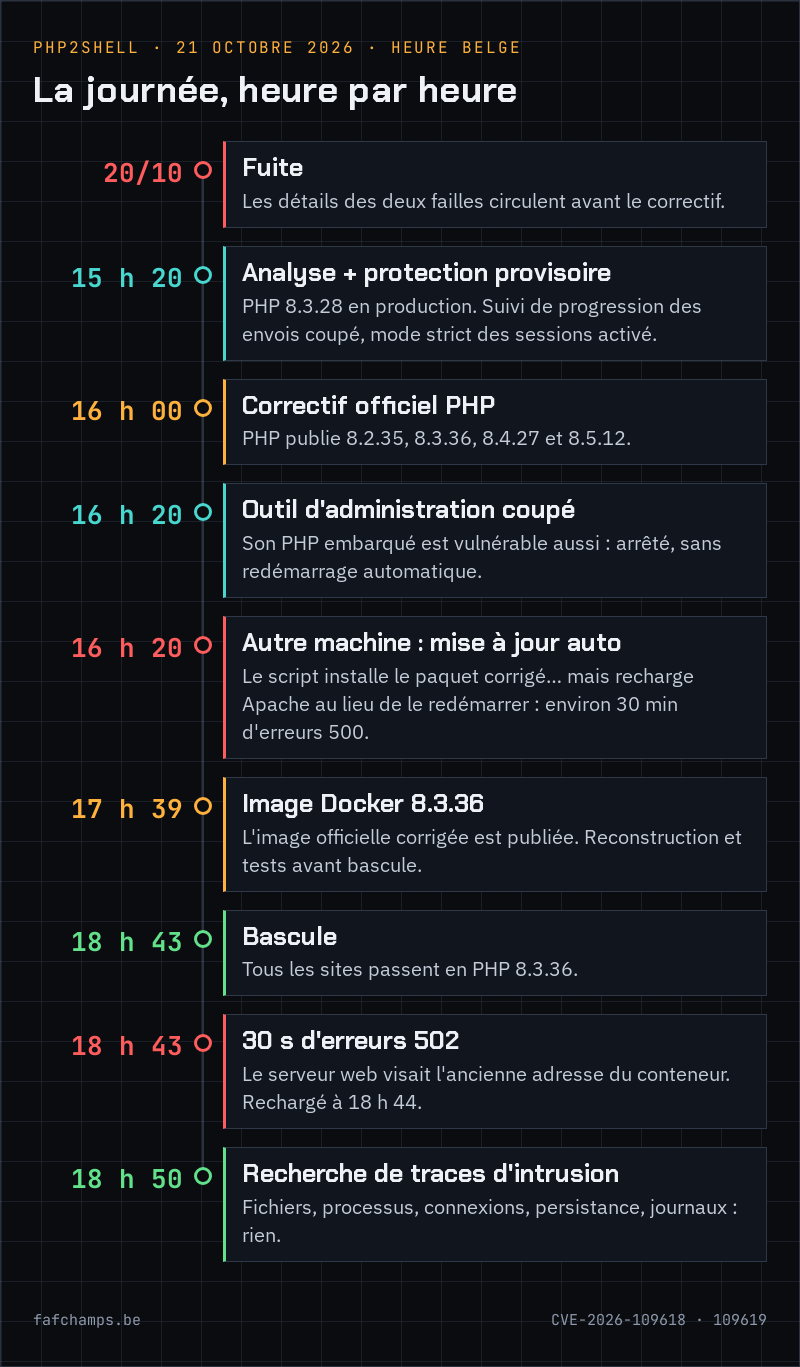
Comment l'alerte est arrivée
Par trois canaux, à quelques heures d'écart. D'abord les CVE elles-mêmes, que je suis. Ensuite la presse spécialisée, qui s'est emballée dès que la fuite a été confirmée. Enfin un fournisseur, qui prévenait ses clients.
C'est ce recoupement qui m'a fait passer en mode incident. Une CVE seule, j'en lis tous les jours. Une CVE + la presse + un fournisseur qui écrit spontanément, ça veut dire qu'il faut s'en occuper aujourd'hui, pas cette semaine.
Les sources ne disaient pas toutes la même chose, et c'est normal à ce stade. Une société de détection n'avait encore rien vu passer chez ses clients. Deux autres, dont un gros fournisseur de CDN, voyaient déjà des tentatives. Une équipe de chercheurs avait reproduit l'une des deux failles. Quand les sources se contredisent sur l'exploitation, je pars du principe que ceux qui voient des attaques ont raison et que les autres ne les ont pas encore vues.
Premier réflexe : savoir ce que j'ai vraiment en production
Avant de toucher à quoi que ce soit, j'ai regardé ce qui tournait. Et la première réponse n'était pas agréable : le PHP de mon serveur principal avait dix mois de retard. Version 8.3.28, image construite en décembre 2025. Sept versions de retard, dont plusieurs avec des correctifs de sécurité. Rien ne s'était cassé, donc personne n'y avait touché. C'est exactement comme ça que ça arrive.
Deuxième constat, lié à mon architecture : un seul PHP sert tous les sites. C'est un choix que j'assume pour la mémoire, mais il a un revers que cette faille rendait très concret : une seule faille, et l'attaquant tient tous les sites d'un coup, avec leurs fichiers et leurs secrets.
Troisième constat : rien devant. Pas de pare-feu applicatif, pas de CDN qui filtre. Les requêtes arrivent directement sur le serveur.
Ce que j'ai fait en attendant le correctif
Il restait un peu moins d'une heure avant la publication officielle, et je savais par expérience que l'image Docker suivrait avec quelques heures de retard. Trois choses, dans cet ordre.
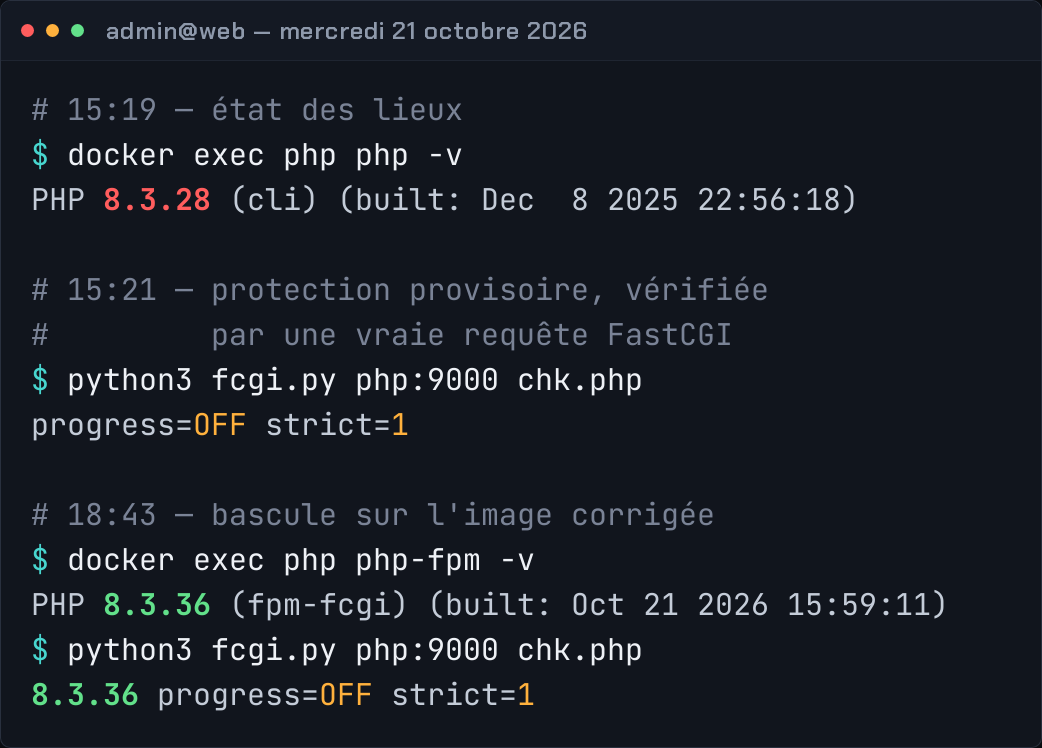
Désactiver la fonctionnalité de PHP visée. Les premières analyses pointaient la fonction de « suivi de progression des envois de fichiers » de PHP. Je l'ai coupée et j'ai activé le mode strict des sessions :
session.upload_progress.enabled = Off
session.use_strict_mode = 1
Rechargement de PHP sans redémarrage, donc sans coupure. Puis vérification avec une vraie requête envoyée au moteur, pas en lisant le fichier de configuration : un réglage écrit au mauvais endroit, c'est un réglage qui n'existe pas. Le seul effet visible pour les utilisateurs : les barres de progression d'envoi ne fonctionnent plus. Les envois eux-mêmes, si.
Je savais que ce n'était pas suffisant. Les développeurs de PHP l'avaient dit clairement : seule la mise à jour protège. Et on a appris ensuite que l'une des deux failles se déclenche aussi par d'autres manipulations des formulaires, sans passer par cette fonction. C'était une protection partielle, présentée comme telle.
Couper ce qui n'avait pas besoin de tourner. L'outil d'administration de bases de données tournait avec son propre PHP, embarqué dans sa propre image, tout aussi vulnérable. Je ne l'avais pas repéré au premier passage, je l'ai vu en vérifiant quels processus tournaient vraiment sur la machine. Il était déjà limité à quelques adresses IP belges, mais un outil d'administration peut attendre la fin d'un incident. Arrêté, et redémarrage automatique désactivé pour qu'il ne revienne pas tout seul au prochain redémarrage de la machine.
Ne pas tout couper. C'était l'option recommandée par certains : mettre les sites hors ligne et afficher une page de maintenance. Je ne l'ai pas fait, et c'est un choix, pas un oubli. Mes clients sont de petites structures : un club de foot, des indépendants, une PME. Une journée hors ligne pour eux, c'est un vrai coût, et le risque, avec la protection partielle en place et une mise à jour dans les heures qui suivent, me paraissait acceptable. Pour une banque ou un hôpital, j'aurais tranché autrement.
Le piège du paquet Debian
En milieu d'après-midi, Debian a mis en ligne un paquet PHP corrigé dans son dépôt de sécurité, avant de publier l'annonce officielle qui l'accompagne d'habitude. Pendant un moment, le site de suivi des failles de Debian ne connaissait même pas ces deux CVE. Quelqu'un qui vérifiait au mauvais endroit concluait qu'il n'y avait pas de correctif. Quelqu'un qui vérifiait au bon endroit voyait le paquet. Les deux avaient raison, à quelques minutes d'écart.
Mais pour mon serveur principal, la question était ailleurs : son PHP ne vient pas de Debian. Il vient de l'image Docker officielle, compilée depuis les sources de php.net. Un apt upgrade sur cette machine n'aurait rien changé, tout en donnant l'impression du devoir accompli. La bonne question n'était pas « le correctif existe-t-il ? » mais « est-ce que mon PHP vient de là où le correctif est publié ? ».
Je retiens ça plus que tout le reste : avant de patcher, savoir d'où vient le binaire qui tourne.
Le script qui attend à ma place
Sur une autre machine dont je m'occupe, PHP vient bien des paquets Debian. Là, je n'avais aucune envie de rafraîchir le dépôt à la main toutes les dix minutes. J'ai écrit un petit script lancé par cron : il interroge le dépôt, installe la mise à jour dès qu'elle apparaît, relance Apache, puis se supprime lui-même.
La suppression automatique, c'est le détail qui compte. Un script de surveillance qu'on oublie de retirer, c'est une tâche qui tourne encore dans un an et que plus personne ne comprend. Celui-ci n'a qu'un travail. Quand il l'a fait, il disparaît. Et s'il échoue, il reste et le dit dans son journal, pour qu'on aille voir.
Il a fait son travail. Et il a cassé Apache.
Le paquet corrigé est arrivé vers 16 h 20. Le script l'a vu, l'a installé, a relancé Apache, a constaté que le service tournait, et s'est supprimé comme prévu. Sur le papier, parfait.
Sauf que pour relancer Apache, il faisait un reload, pas un restart. Sur une machine où PHP tourne comme module d'Apache (mod_php), ça ne pardonne pas. Un reload garde le processus principal d'Apache et ne remplace que les processus qui traitent les requêtes. Le processus principal avait toujours l'ancienne version de PHP chargée en mémoire, les nouveaux processus tombaient sur les fichiers de la nouvelle. Deux versions de PHP mélangées dans le même serveur : symboles introuvables, plantages en série, erreurs 500 sur les sites.
Et le script n'a rien vu, parce qu'il vérifiait la mauvaise chose. Pour systemctl, Apache était « actif ». Il l'était : le processus principal tournait très bien. C'étaient ses processus enfants qui mouraient à chaque requête.
Les sites sont restés en erreur une trentaine de minutes. Un restart complet, et tout est rentré dans l'ordre. Trente minutes d'erreurs sur des sites qui, au moins, n'étaient plus vulnérables. Mais j'aurais dû tester les sites juste après la mise à jour, au lieu de faire confiance au script qui me disait que tout allait bien.
Pour remettre les choses à leur place, sans me chercher d'excuse : ce soir-là, des dizaines de sites belges, sans doute des centaines, étaient hors ligne de leur plein gré. Vu du visiteur, mon erreur a produit la même chose : un site indisponible, ici pendant une demi-heure. Avec deux différences. Ce n'était pas voulu, et une erreur 500 est bien moins propre qu'une page de maintenance qui explique pourquoi. La démarche, elle, était inverse : couper en attendant de pouvoir mettre à jour d'un côté, mettre à jour le plus vite possible, automatiquement, pour ne pas avoir à couper de l'autre. Cette machine a fini par avoir sa « maintenance express » à elle : trente minutes, non annoncée.
La leçon est la même que pour la protection provisoire plus haut : on vérifie avec une vraie requête, pas en demandant au service s'il va bien. Un service actif n'est pas un service qui fonctionne.
Voici donc le script tel qu'il aurait dû être, réécrit pour l'article et un peu simplifié. Deux changements par rapport à la version qui a tourné : un vrai restart, et une page de test qui doit renvoyer la nouvelle version de PHP, en HTTP, avant que le script ait le droit de disparaître.
#!/bin/bash
# attendre-correctif-php.sh — lancé par cron toutes les 5 minutes.
# Installe la mise à jour de sécurité PHP dès qu'elle est publiée, vérifie
# PAR UNE VRAIE REQUÊTE HTTP que PHP répond dans sa nouvelle version, puis
# supprime sa page de test, sa tâche cron et lui-même.
# En cas d'échec, il NE se supprime PAS : il reste, et il le crie.
set -euo pipefail

PAQUET=libapache2-mod-php8.2           # le paquet qui fait foi pour la version
PAGE_TEST=/var/www/html/version-php.php  # contient : <?php echo PHP_VERSION;
URL_TEST=http://127.0.0.1/version-php.php
TACHE=/etc/cron.d/attendre-correctif-php
JOURNAL=/var/log/attendre-correctif-php.log
log() { echo "$(date '+%F %T') $*" >> "$JOURNAL"; }

# Deux exécutions en même temps = deux apt en même temps : on l'évite.
exec 9>/run/attendre-correctif-php.lock
flock -n 9 || exit 0

apt-get update -qq
installe=$(dpkg-query -W -f='${Version}' "$PAQUET")
candidat=$(apt-cache policy "$PAQUET" | awk '/Candidat|Candidate/ {print $2}')

if ! dpkg --compare-versions "$candidat" gt "$installe"; then
    log "pas encore : $installe installé, rien de plus récent"
    exit 0
fi

log "mise à jour disponible : $installe -> $candidat"
# Uniquement les paquets PHP déjà installés, rien d'autre.
mapfile -t paquets < <(dpkg-query -W -f='${binary:Package}\n' 'php8.2*' "$PAQUET" 2>/dev/null | sort -u)
DEBIAN_FRONTEND=noninteractive apt-get install -y -qq --only-upgrade "${paquets[@]}"

# RESTART, jamais reload. Avec mod_php, un reload garde le processus
# principal d'Apache, qui a encore l'ancien PHP en mémoire : versions
# mélangées, plantages, erreurs 500. Vécu le 21/10 : trente minutes.
systemctl restart apache2

# Ne pas demander à systemctl si Apache va bien : il répond « actif »
# même quand chaque requête plante. On demande à PHP lui-même, en HTTP.
attendu=${candidat%%-*}                # 8.2.35-1~deb12u1 -> 8.2.35
reponse=""
for essai in 1 2 3 4 5 6; do
    reponse=$(curl -fsS --max-time 5 "$URL_TEST" 2>/dev/null || true)
    [ "$reponse" = "$attendu" ] && break
    sleep 5
done

if [ "$reponse" = "$attendu" ]; then
    log "OK : PHP $reponse répond en HTTP. Le script se retire."
    rm -f -- "$PAGE_TEST" "$TACHE" "$0"
else
    msg="ÉCHEC : la page de test répond « ${reponse:-rien} », attendu $attendu. Le script reste en place."
    log "$msg"
    echo "$msg" >&2                    # cron l'envoie par mail : impossible de le rater
    exit 1
fi
Et la tâche cron qui va avec :
# /etc/cron.d/attendre-correctif-php
*/5 * * * * root /usr/local/sbin/attendre-correctif-php.sh
Installer une mise à jour automatiquement, sans fenêtre de validation, ce n'est pas ce que je ferais partout. Ici je pouvais me le permettre : des sites de petites structures, une mise à jour de sécurité d'une version mineure, et une sauvegarde récente. Le risque d'une régression était bien plus faible que celui de rester exposé une heure de plus. Et même avec les trente minutes d'erreurs, je referais le même choix : un site en erreur 500 se répare en une commande, un site compromis beaucoup moins.
Le correctif définitif, et la petite erreur
Sur le serveur principal, l'image Docker corrigée (PHP 8.3.36) est sortie vers 17 h 40. J'ai reconstruit l'image et je l'ai testée avant de basculer : bonne version, mêmes extensions que l'ancienne, protection provisoire toujours en place. L'ancienne image est gardée sous un autre nom, au cas où il faudrait revenir en arrière. Puis bascule, vers 18 h 45.
Et là, les sites PHP sont tombés en erreur 502. Pendant une trentaine de secondes.
La cause est bête et je la connaissais en théorie : en recréant le conteneur PHP, Docker lui donne une nouvelle adresse sur le réseau interne. Le serveur web, lui, avait gardé l'ancienne en mémoire et frappait dans le vide. Un rechargement du serveur web, et tout est revenu. C'est maintenant écrit dans ma procédure : après chaque recréation du conteneur PHP, on recharge le serveur web, immédiatement, sans attendre de voir si ça casse.
Trente secondes, un mercredi soir, sur de petits sites. Ce n'est pas grave. Mais je préfère l'écrire que le cacher : un compte rendu d'incident sans erreur dedans, c'est un compte rendu incomplet.
Vérifier que personne n'est entré
Une fois le correctif en place, il restait la vraie question : est-ce que quelqu'un est passé pendant la journée et demie d'exposition entre la fuite et la mise à jour ?
J'ai cherché ce qu'une intrusion réussie laisse d'habitude derrière elle :
- les fichiers créés ou modifiés depuis la fuite dans les dossiers des sites, en particulier tout ce qui est exécutable :
.php,.phtml,.phar,.user.ini,.htaccess; - les signatures classiques de webshells : du code décodé puis exécuté à la volée, des commandes système alimentées directement par une requête, les noms des outils connus ;
- du PHP caché dans des dossiers d'envoi ou d'images ;
- des processus lancés par l'utilisateur du serveur web autres que PHP lui-même, et des connexions sortantes depuis le conteneur PHP ;
- les tâches planifiées, les comptes et les clés SSH de la machine ;
- les fichiers ajoutés dans le conteneur de l'outil d'administration arrêté ;
- dans les journaux, chaque requête POST ayant abouti, et chaque fichier
.phpappelé, comparé à ce qui existe réellement sur le disque.
Résultat : rien. Des scanners en pagaille, comme tous les jours. La plupart de leurs requêtes ont été refusées, et aucune n'a atteint autre chose que des pages qui existent réellement. Des envois de formulaires uniquement vers des scripts connus. Un faux positif amusant : un site qui renvoie sa page d'accueil pour n'importe quelle adresse, et que les robots prenaient pour un fichier de configuration WordPress oublié.
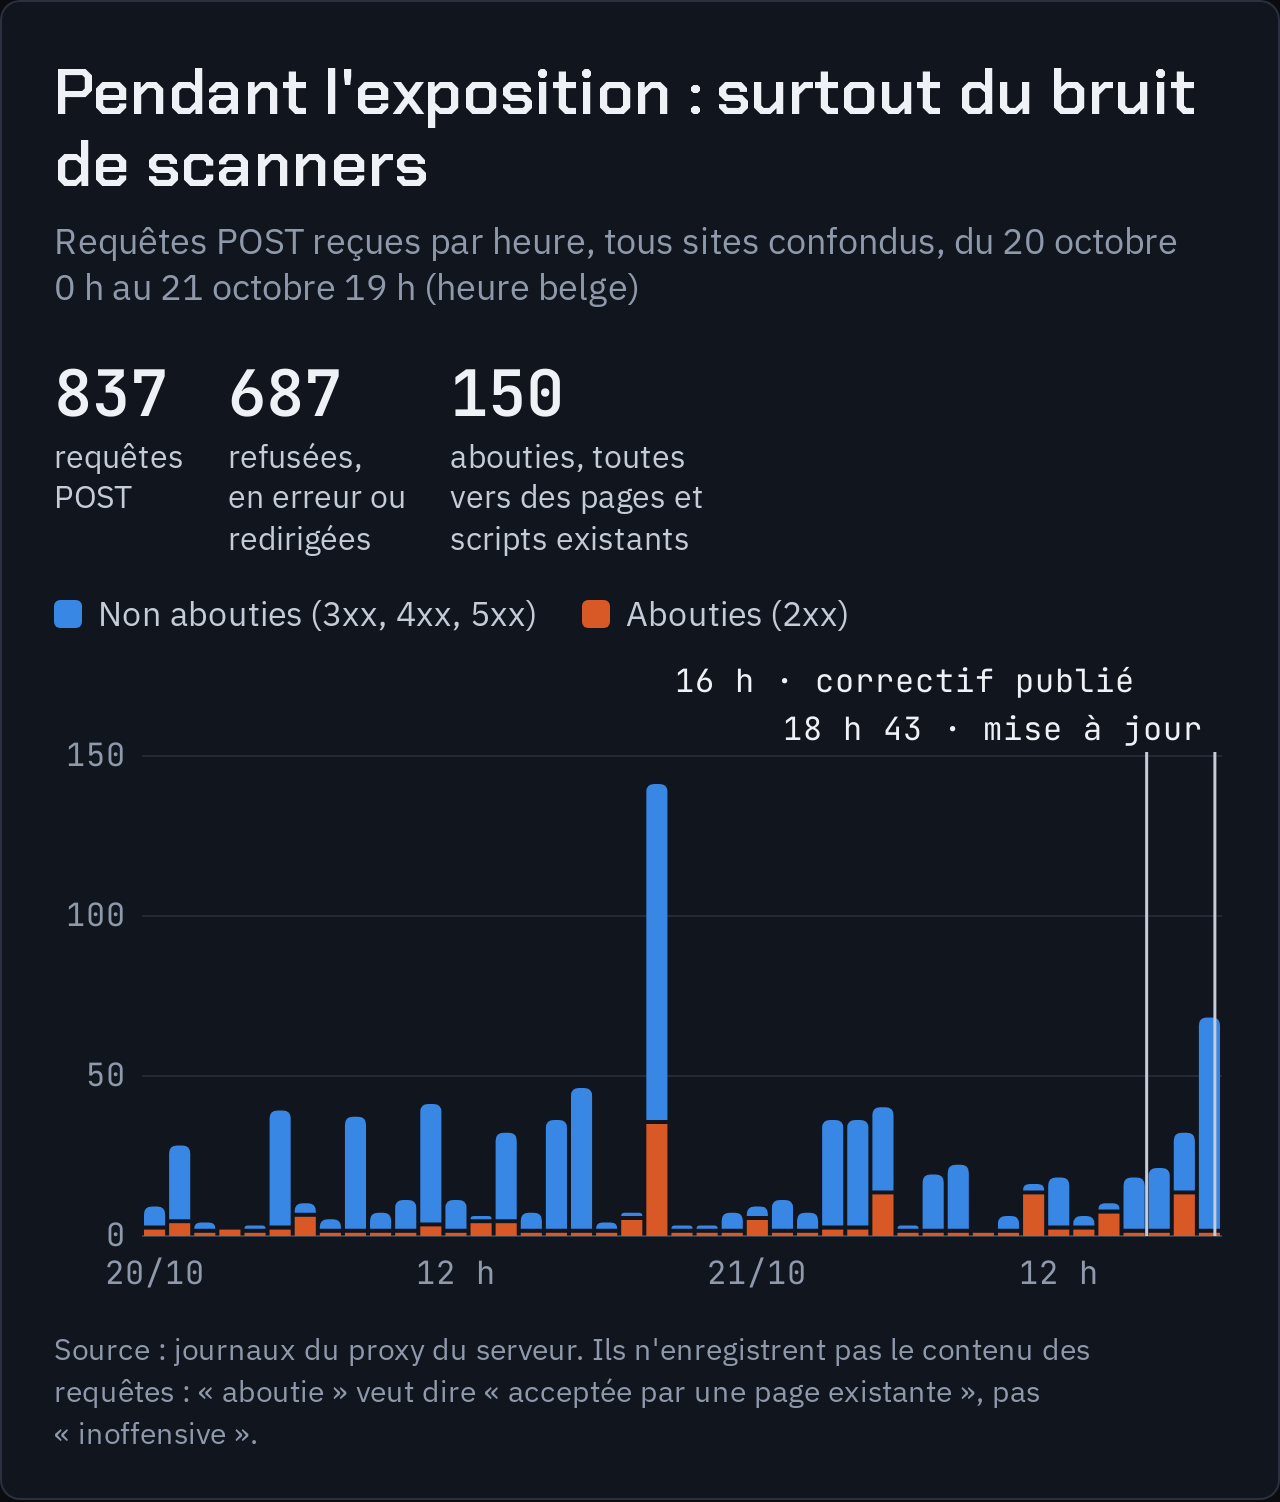
Je n'écris pas « je suis certain que personne n'est entré », pour la même raison : ne pas avoir trouvé de trace n'est pas une preuve d'absence. J'écris « je n'ai trouvé aucune des traces qu'une intrusion laisse habituellement ». Et j'ajoute une limite que je me suis créée moi-même : en recréant le conteneur PHP, j'ai effacé son dossier temporaire et son journal d'erreurs. Je les avais regardés quelques heures plus tôt, rien d'anormal, mais je ne pouvais plus les réexaminer après coup. La prochaine fois, je les copie avant de reconstruire.
Une Belgique en page de maintenance
Le soir même, une fois mes serveurs à jour, j'ai fait le tour du web belge. Pas pour me rassurer, plutôt par curiosité professionnelle : je voulais voir comment les autres géraient.
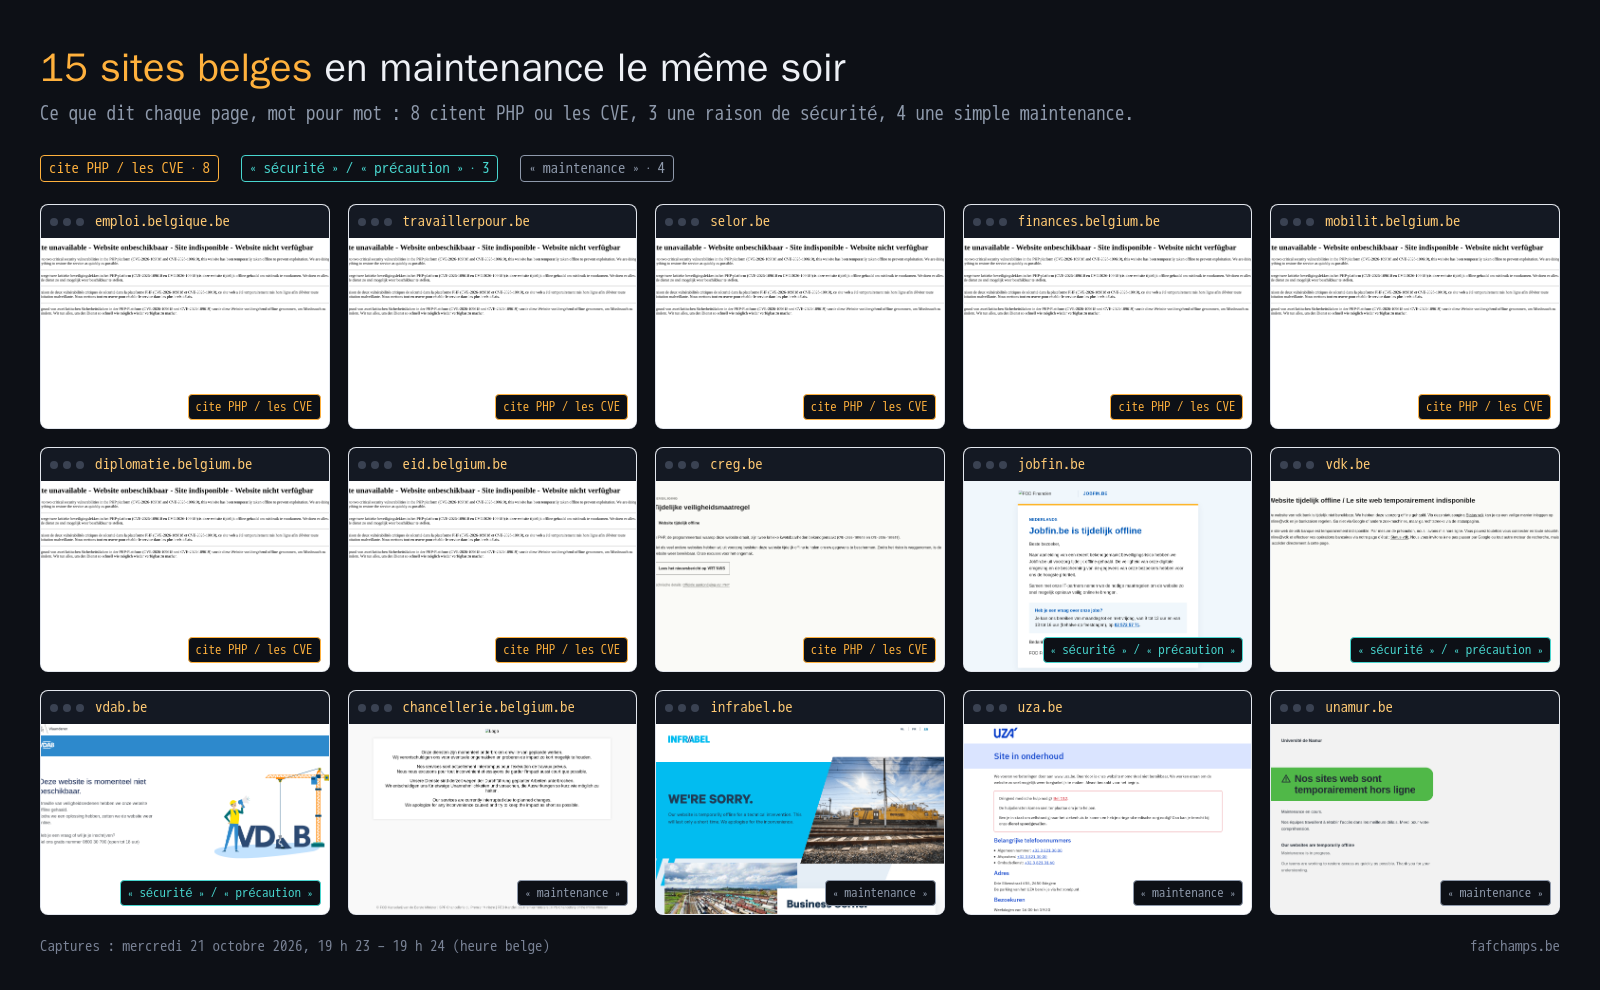
Le mercredi 21 octobre, vers 19 h, voici ce qui répondait, vérifié un par un. Je m'en tiens à ce que dit chaque page : une page de maintenance ne prouve pas, à elle seule, que le site a été coupé à cause de PHP2Shell.
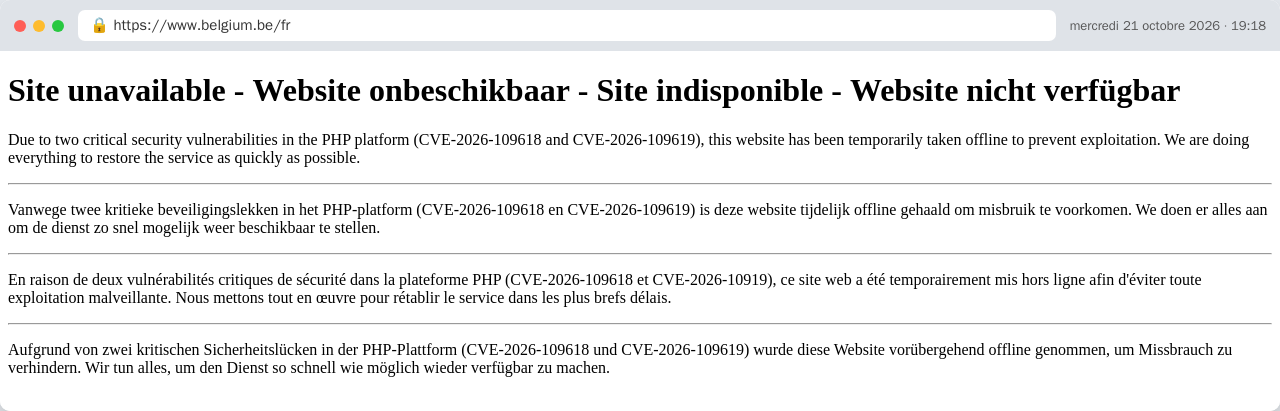
- Les pages qui citent la faille noir sur blanc. belgium.be, le portail de l'État. finances.belgium.be, jusqu'à sa page de recrutement. Le site de la Mobilité, celui des Affaires étrangères, celui de l'eID. Le recrutement public : emploi.belgique.be, travaillerpour.be, Selor. Tous affichent la même page, en quatre langues, qui cite les deux CVE et explique que le site a été retiré « pour empêcher l'exploitation ». La CREG va plus loin et explique elle-même que son site tourne sur PHP.
- Celles qui parlent de sécurité sans nommer la faille. jobfin.be évoque un « risque de sécurité récemment rendu public », le VDAB des « raisons de sécurité », et la banque vdk une coupure « par précaution », en renvoyant ses clients vers une page de statut pour qu'ils ne cherchent pas leur banque en ligne sur Google.
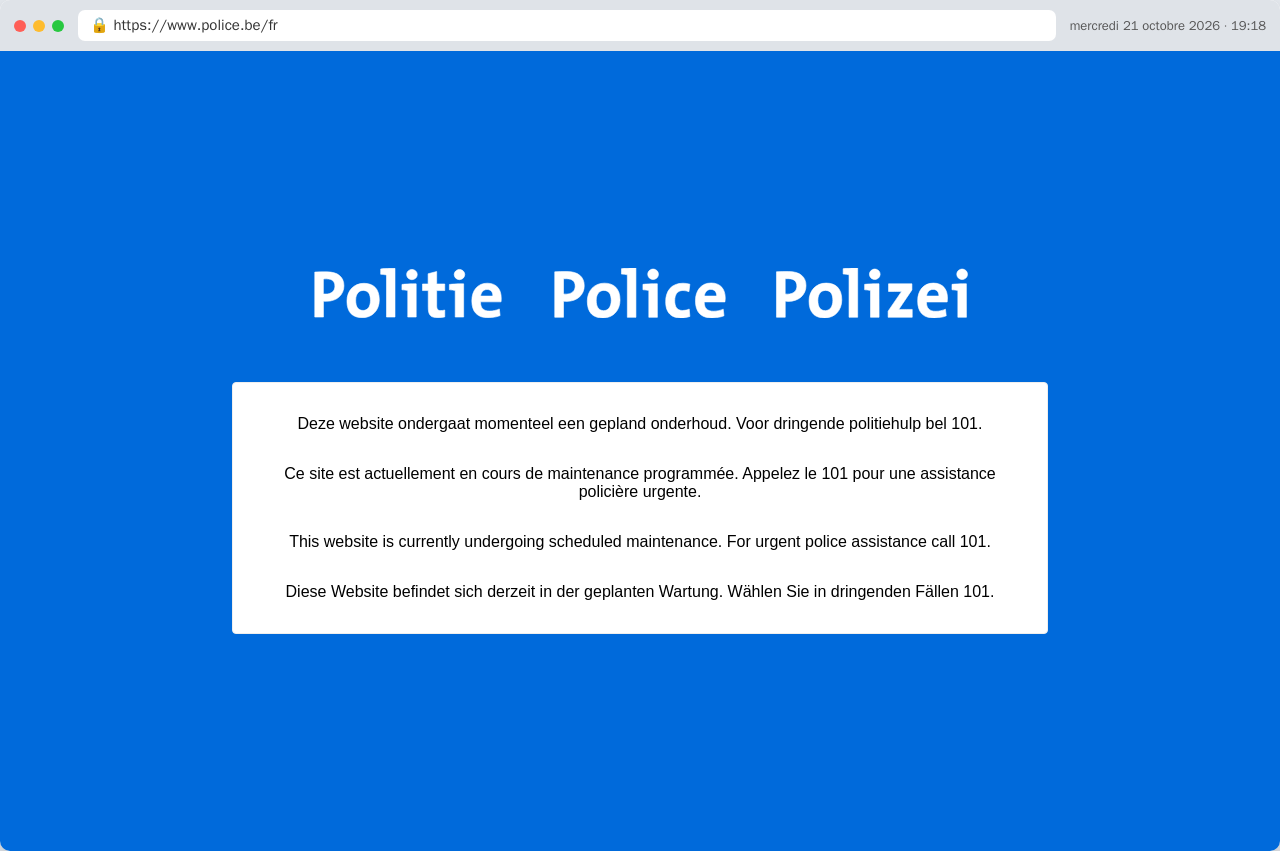
- Celles qui annoncent une simple maintenance. La Chancellerie du Premier ministre, Infrabel, l'UZA à Anvers, l'Université de Namur, la ligne d'écoute Awel, et police.be, qui parle d'une maintenance « programmée » avec le 101 pour les urgences. Le lien avec PHP2Shell est probable vu le moment, et la presse le confirme pour certains d'entre eux, mais leurs pages ne le disent pas. poljob.be, le site de recrutement de la police, ne répondait plus du tout : impossible de savoir pourquoi.
La presse (VRT NWS ↗, RTBF ↗, TechPulse ↗) en cite bien d'autres, que je n'ai pas vérifiés moi-même : les tribunaux et le parquet, une dizaine d'hôpitaux, des zones de police locales, des sites de DPG Media et de Roularta, Smartschool, le port d'Anvers-Bruges, la VUB. La SNCB, elle, restait en ligne, derrière un pare-feu applicatif : une autre façon de gérer le même risque.
Je suis sur Internet depuis mes 14 ans. J'ai connu les grands vers, qui faisaient peur mais pour lesquels personne ne débranchait ses serveurs, les grosses pannes de fournisseurs, Heartbleed, Log4Shell. Je n'avais jamais vu autant de sites fermer en même temps par précaution. Pas parce qu'ils étaient tombés, ni parce qu'ils avaient été piratés : parce que leurs responsables ont estimé qu'un site éteint valait mieux qu'un site ouvert sur une faille connue de tous. C'est une forme de maturité qu'on n'aurait pas vue il y a dix ans.
Leur choix et le mien ne s'opposent pas. Une administration ou un hôpital gère des dizaines de sites, souvent à travers plusieurs prestataires, avec des données sensibles derrière : couper en attendant d'avoir une vue complète était, pour eux, la décision raisonnable, et celle que recommandait le CCB. Ma situation était beaucoup plus simple : une poignée de sites, et, après une heure d'état des lieux, une idée précise de ce qui tournait, d'où venait chaque binaire et de ce que je ferais à la minute où le correctif sortirait. Situations différentes, décisions différentes.
Aparté : quatorze ans sous nos pieds
Il y a un détail que je n'arrive pas à digérer. Les failles touchent PHP depuis la version 5.4. PHP 5.4, c'est mars 2012. Le défaut était donc là depuis plus de quatorze ans, dans le moteur qui fait tourner une énorme partie du web, relu par des milliers de développeurs, audité, scanné, fuzzé.
Et on ne s'en rend compte que maintenant.
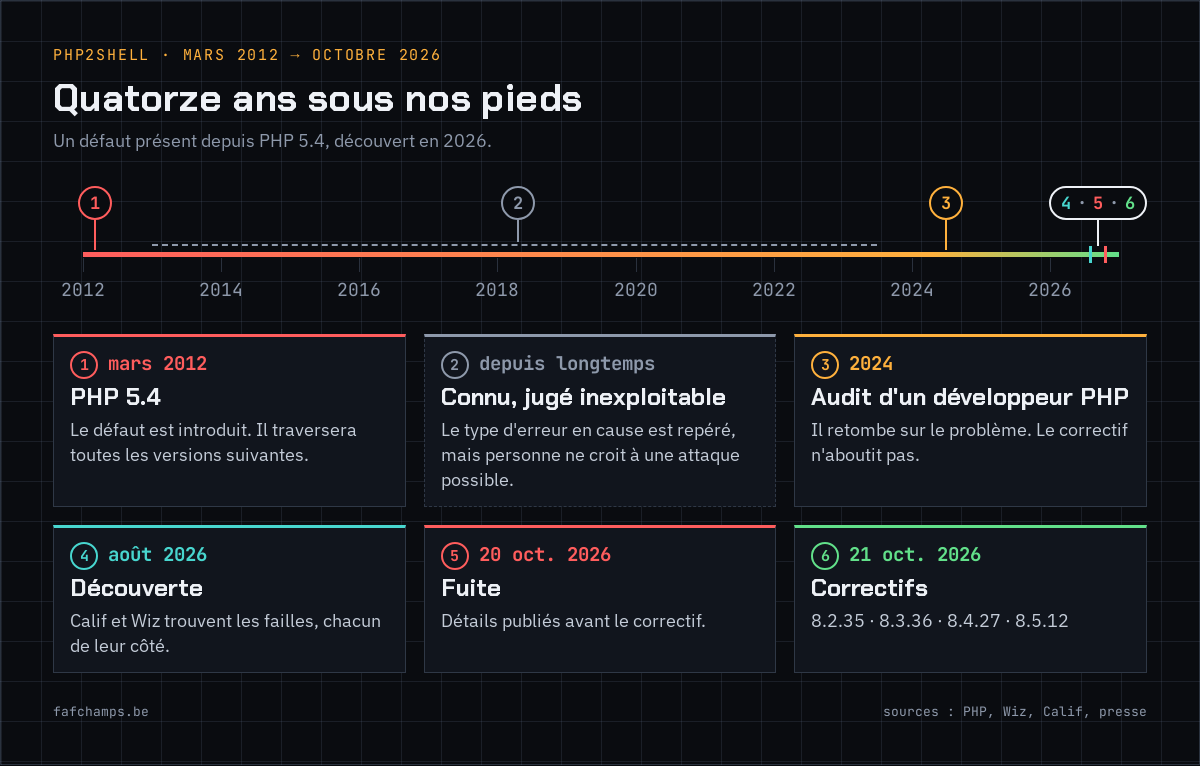
Ce n'est pas tout à fait vrai, d'ailleurs, et c'est presque pire. D'après ce qui a été publié depuis, le type d'erreur en cause avait déjà été repéré il y a longtemps, mais personne ne pensait qu'on pourrait en tirer une attaque exploitable. Un développeur de PHP était même retombé dessus lors d'un audit en 2024, et le correctif n'avait pas abouti. Le défaut était connu. C'était son exploitation qui paraissait impossible.
Qu'est-ce qui a changé en 2026 ? Beaucoup pensent spontanément à l'intelligence artificielle, et c'est tentant. Deux équipes ont trouvé les failles indépendamment l'une de l'autre, en août. L'une d'elles, d'après le Wall Street Journal, travaillait avec un modèle d'OpenAI. Les chercheurs de Wiz, eux, disent que les modèles d'IA les plus avancés ont « nettement abaissé la barrière » pour transformer ce défaut ancien en exploit. Mais à l'heure où j'écris, on ignore si c'est l'IA qui a réellement détecté la faille, ou si elle a seulement aidé des chercheurs qui savaient déjà où chercher. Personne n'a publié le détail de la découverte, et je me méfie des récits trop simples.
C'est là que ça fait peur. Si des chercheurs l'ont trouvé en 2026, avec ou sans IA, qui l'a trouvé avant eux, sans rien dire ? Un groupe criminel organisé, un service de renseignement, quelqu'un qui avait de bonnes raisons de garder ça pour lui ? On ne le saura sans doute jamais. Une faille qu'on exploite discrètement pendant des années ne fait pas de bruit, et c'est précisément pour ça qu'elle vaut cher.
Et quel que soit le rôle exact de l'IA cette fois-ci, ces outils sont à la disposition de tout le monde, défenseurs comme attaquants. Il y aura d'autres failles de quatorze ans. Le rythme va s'accélérer, et le temps entre la découverte et l'exploitation va se raccourcir. Être capable de patcher dans l'heure n'est plus un luxe.
« Aucune attaque recensée » : une nuance
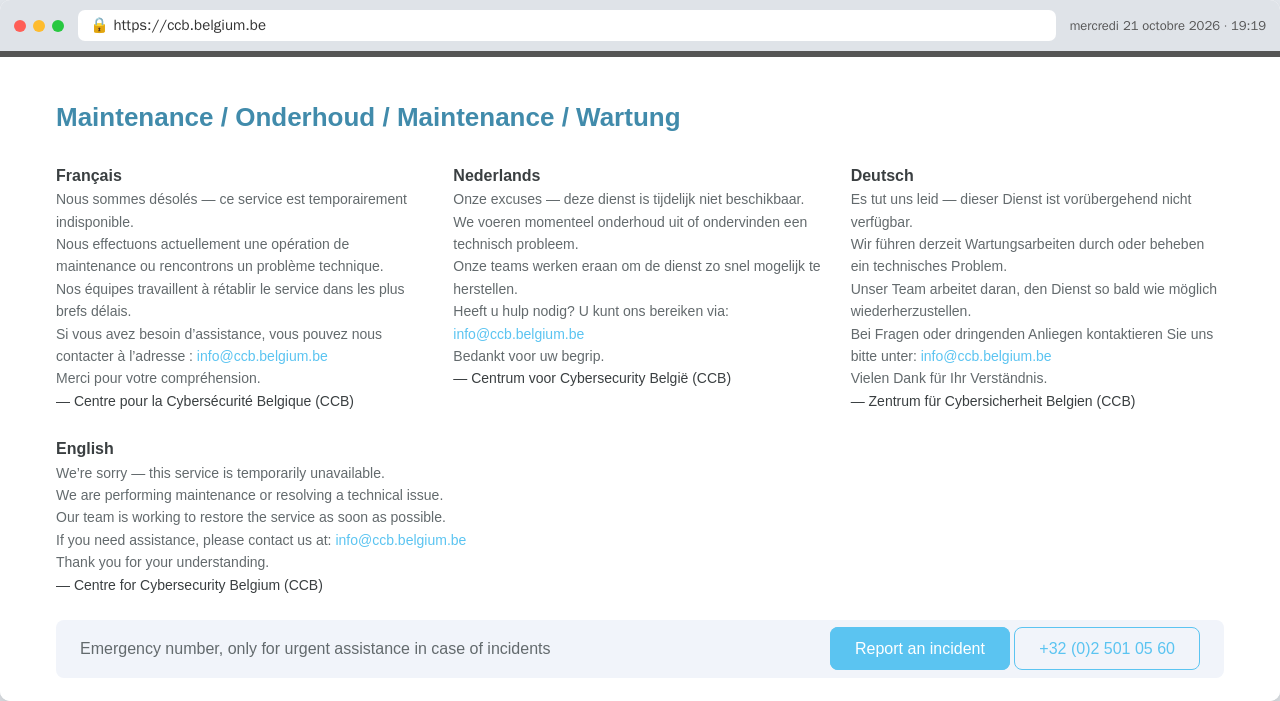
Le Centre pour la Cybersécurité Belgique (CCB) a été cité partout dans la presse le 21 octobre. Côté néerlandophone, à la VRT ↗ : le CCB « ne voit encore aucune attaque dans notre pays ». Côté francophone, via Belga ↗ : il n'avait « pour l'instant recensé aucune attaque contre des sites web belges ». Dans le même message, il recommandait d'installer le correctif au plus vite et, à ceux qui ne pouvaient pas le faire tout de suite, de mettre leur site hors ligne. Son propre site affichait d'ailleurs une page de maintenance ce soir-là, liée à la faille d'après La DH.
Le message était juste et cohérent : on ne voit pas d'attaque, mais coupez quand même si vous ne pouvez pas patcher. C'est exactement ce qu'on attend d'un centre national dans ce genre de situation : informer sans affoler, et donner une consigne claire.
Je voudrais seulement ajouter une nuance, parce que cette première phrase a beaucoup circulé seule, et qu'on peut facilement la lire de travers. « Aucune attaque recensée », ce n'est pas la même chose que « aucune attaque ». Le CCB dit précisément ce qu'il sait : il recense ce qu'on lui signale et ce que remontent ses capteurs. Par nature, il ne peut pas voir les journaux des milliers de petits sites belges hébergés sur des serveurs que personne ne surveille vraiment. Et cette faille-là se prête mal à la détection : l'attaque passe par un envoi de formulaire tout à fait banal en apparence, et les journaux d'un serveur web standard n'enregistrent pas le contenu des requêtes. Une exploitation réussie peut très bien ne laisser qu'une ligne « POST, 200 » au milieu de milliers d'autres.
Au même moment, Cloudflare disait voir des attaques dans le monde entier. Avec le nombre de sites PHP en Belgique, dont une bonne partie sur des versions plus maintenues depuis longtemps, il serait prudent de ne pas lire « aucune attaque recensée » comme « on est passé entre les gouttes ». Certains sites touchés ne le savent peut-être pas encore, et ne l'ont donc signalé à personne. Si vous gérez un site PHP, vérifiez-le vous-même plutôt que de vous fier à l'absence de mauvaise nouvelle.
Ce que je garde de cette journée
- Savoir d'où vient chaque binaire. Paquet de la distribution, image Docker, compilé à la main : trois chemins de mise à jour différents, et un correctif publié sur l'un ne touche pas les autres.
- Une image qui ne bouge pas vieillit en silence. Dix mois sans reconstruction, sans que rien ne casse. La reconstruction devient régulière, pas seulement en cas d'urgence.
- Une protection provisoire est provisoire. Elle achète du temps. Elle ne remplace pas le correctif, et il faut le dire à ceux qui demandent si « c'est bon ».
- Couper ce qui ne sert pas, garder ce qui fait vivre les clients, et assumer ce choix plutôt que de tout éteindre par réflexe.
- Un service actif n'est pas un service qui fonctionne. Mes deux pannes de la journée, les 30 secondes de 502 et les 30 minutes de 500, ont la même cause : avoir fait confiance à l'état du service plutôt qu'à une vraie requête.
- Les scripts d'urgence doivent savoir disparaître, mais seulement après avoir prouvé que tout fonctionne.
- Écrire les erreurs. Les trente secondes de 502, le dossier temporaire effacé : c'est là qu'on apprend quelque chose.